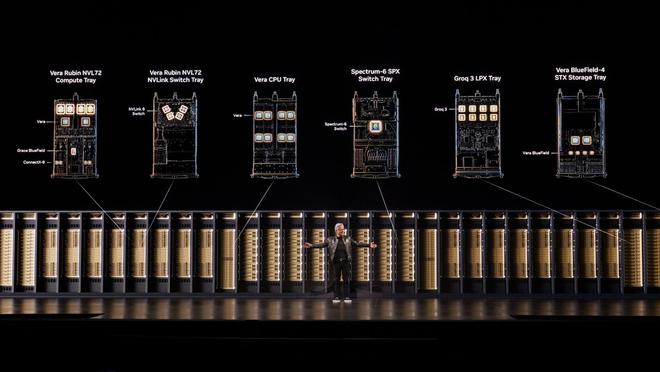
为此,英伟达建议采取全维度的协同优化方案,涵盖GPU、CPU、网络、存储以及软件系统的统一设计。该方案融入了模型权重低精度表示、键值缓存压缩、多层级存储架构和检索内容优化等多项前沿技术,旨在增强整个AI基础设施对内存的利用程度。英伟达的数据显示,在从黑威尔超级版本升级至韦拉鲁宾新平台的过程中,单颗处理器所配高带宽内存容量的增幅仅为3%左右,然而在特定的智能体任务场景中,每投入单位成本所获得的处理能力却可达到30倍的增长。
该方案的关键理念在于:把整个AI运算中心的存储体系看作一个有机的整体,各层级协调配合。而不是一味执着于往速率最高、成本最昂贵的GPU内存中堆砌更多数据。这样可以以更经济的成本基础,完成更多的人工智能处理工作。
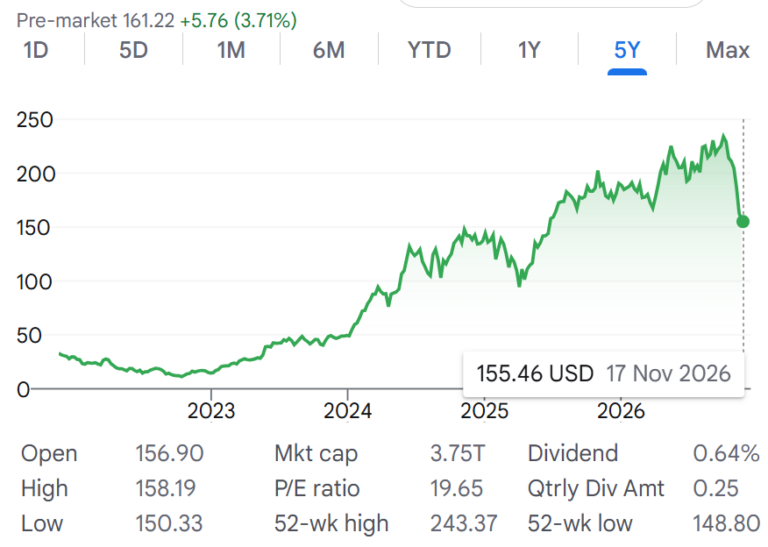
引人注目的是,这篇技术文章问世的同一天,英伟达股票却遭遇了市场的大规模抛压。周四交易中,股价曾一度下滑超过9%,不仅消磨了该公司今年以来的整体增幅,还让市值相比10月的峰值蒸散了接近1.4万亿美元的财富。
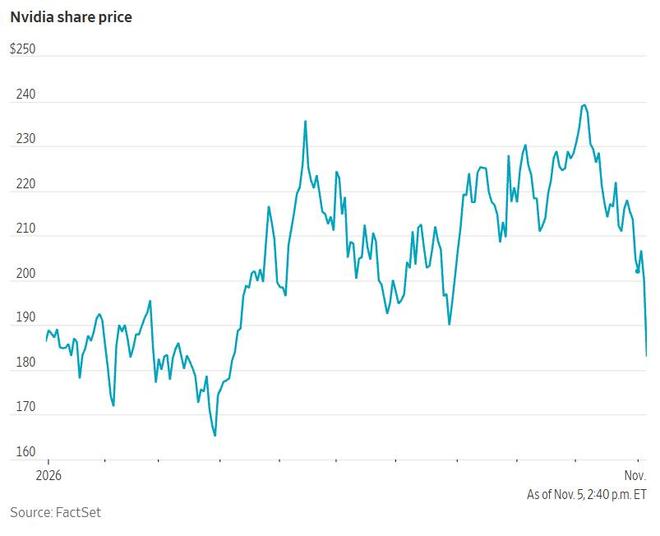
这场抛售风潮的深层原因是,投资者在重新评估AI基础设施建设的获利周期、数据中心铺设的进展状况,以及相关企业股票的合理估值。这反映出整个行业的发展重心正从单纯的计算力竞赛向投资收益效能转移。英伟达强调的这套全栈协同理念,本质上是在用系统运行效能和每个词元的成本来回应AI基础设施扩展过程中面临的资源和成本制约。
大模型与智能体驱动内存需求飙升,单纯堆叠高带宽内存无法奏效
英伟达指明,随着大型模型所含参数总数的扩增、对话上下文范围的拉长,再加上智能体在循环推理与工具交互间需不断维持之前的状态记录,GPU的高速带宽存储面临了空前的压力。
这当中,键值缓存作为推理计算的主要内存占用构成。它的功能是记下模型在处理各类请求期间已运算过的背景数据,让模型之后能够引用这些信息而不用一遍遍重新计算。对于智能体来说,执行一项操作时常常涉及多次的模型运算、插件使用以及反馈接收,之前的数据会源源不断累加,相应的缓存量也会随之膨胀。英伟达透露,有些智能体任务的完整轨迹所涉及的数据处理规模已然达到了300万个字符单位。
另外值得一提的是,检索强化生成这类技术框架要求把企业的各类文档转化成向量形式,在模型推理期间搜寻并提取相关的片段,这势必会增添需要处理和存储的数据规模。
英伟达指出,在推理运行中,模型的参数集和缓存信息均需占据高带宽内存空间。偏偏这个内存层级正是AI运算中心内速度首屈一指、花费最大、获取也受最多约束的存储等级。
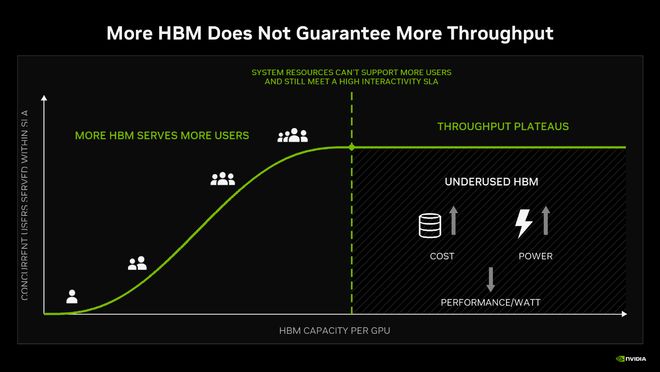
仅仅扩大高带宽内存规模并非灵丹妙药。英伟达用仓储设施来打比方:将高带宽内存看作仓库,把存储带宽想象为仓库前的作业区。虽然更宽敞的仓库确实能堆放更多货物,但若作业区的处理效率达不到要求,再大的仓库也无法实质上增加物流吞吐。
在AI推理的执行中,虽然充足的高带宽内存空间确能承载更多访问者的模型任务和缓存信息,但各个访问者最终还是要瓜分有限的GPU运算力和存储带宽资源。若运算能力或通道容量出现瓶颈制约,那多出来的内存空间就有可能形同虚设,徒增系统的成本投入与电耗负担。
基于这一认识,英伟达主张,关键不在于无脑地增加存储规模,而是要确保各类数据得以存放在最恰当的层级位置,必要的时候再迅速转移回GPU,从而提升全系统的工作效能。
低精度格式压缩权重参数,机架互联实现72颗GPU分布存储
为缓解模型参数大量占据高带宽内存的困扰,英伟达建议采取低精度化方案,借助自家的NVFP4格式来压缩模型参数,同时凭借NVLink技术实现多GPU间的协同存储。
从技术角度讲,这一格式能把模型参数的精度缩小到4比特,相对于FP8标准更进一步地压缩了占用空间。英伟达表示,许多模型研发机构和企业已经开始用这种格式来发布他们的模型参数,包括黑森林实验室、思考机器实验室、反思公司以及Meta旗下某些模型都采纳了这套方案。
硬件端,英伟达利用NVLink技术搭建了支持72颗GPU的机架级互联体系。这个系统让模型参数能够分散存放到72个处理器上,每颗处理器只保管模型的片段内容,这样就腾出了额外的高速存储空间,可以存放缓存或应对更多实时用户访问。
这表明英伟达的策略是,联合运用低精度转化和大规模互联技术来应对模型参数内存占用的难题,而非一味依靠单个处理器的高带宽内存扩张。
缓存多层分解与动态卸载,Vera处理器与Dynamo软件协调管理
相较于固定的模型参数,缓存面对的处境更为灵活多变。当智能体持续运行推理、触发各类插件和等候来自外界的反馈时,有些历史数据需要留存,但并非每条信息都应该一直坐在最迅捷、最昂贵的GPU存储里。
针对此点,英伟达提出了压缩、临存和分级外移三管齐下的优化思路。
首先这一低精度格式也适用于缩小缓存的体积,跟FP8的做法比起来进一步缩减了占用空间,让更多背景信息得以驻扎在处理器的高速存储内。
其次是Vera处理器负责加速各类工具的调度,用来减少智能体在等候外界工具执行反馈期间缓存闲置的时段。同时Vera处理器集成了大规模的LPDDR储存层,通过NVLink-C2C协议与Rubin图形处理器相连,可为临时非活动的背景提供靠近GPU的临时存储,一旦需要即刻拉回。
第三方面,英伟达开发的Dynamo推理引擎能够把临时闲置的缓存从GPU存储转移到CMX上下文内存池。CMX这一架构层主要面向大规模、经济型的数据保管,其单位比特的成本远远低于高带宽内存等级,而且在背景信息被再度激活之前能迅速恢复这些数据。
有别于服务器本地固态盘,CMX支持跨越多台机器的共享使用;区别于老式的商务存储系统,它无须为这些生存周期短暂的背景数据承受常年防护所附加的支出。
英伟达同时利用Dynamo内建的缓存复用模块,把GPU储存区、处理器储存区和外围存储区里的缓存当作整个系统的共通资源进行协调安排,让已然经过一遍运算的背景信息能在全系统内反复利用,降低冗余的运算消耗。
向量模型与搜索引擎优化检索系统,企业知识库不再抢占高速存储
除却模型参数和缓存外,英伟达对检索强化生成技术带来的存储负荷也给出了优化之策。
这一技术需要把企业各类文件变成向量化的数学表达方式,再构建一份能够被查询的向量表单,好让模型能依照提问者的意图从海量资料池里摘取恰当的内容。若这些向量信息全都放进处理器的高速存储,就会进一步挤压模型运算所必需的稀缺内存。
英伟达建议借用NeMo Retriever和cuVS这两个工具分头优化向量讯息与索引库的存储方法。
前者,NeMo Retriever这一模型系统能生成尺寸更小的向量编码,与此同时增进检索的命中率,借此减轻需要存储与流转的数据总量;后者cuVS则允许在处理器存储和更低阶层构建和执行大规模向量表单库,使公司的整套资料库可以不占据GPU的高速存储。
唯有确实被筛选出来、模型需要运用的相关章节,才会被导入模型的处理区域。
采取这套办法,英伟达旨在缩减模型参数、闲置背景和检索强化系统对高速存储的抢占,把更大的处理器存储空间保留给具体的运算工作和多用户并行服务。
告别内存堆叠时代,单位资源产出劲升30倍的新范式
英伟达所发布的技术数据指标,成了这份全栈协同策略文章中最令人瞩目的看点。
公司引用了SemiAnalysis AgentX性能对标中包含的DeepSeek V4 Pro任务案例,用以比较多个时代AI运算平台的处理能力和经济表现。
具体地讲,当每个用户每秒要接收100个字符单位的响应速率时,相较H200体系,GB300 NVL72机架每块钱带来的处理效能最多增加了10倍,此间单颗处理器的高速存储容量约莫增长了一倍。
若每个用户每秒需求接收125个字符单位,对比GB300 NVL72机架而言,Vera Rubin NVL72机架每块钱所产生的处理效能最高能增加30倍,此时单个处理器的高速存储容量却只增添了大约3%。
这表明在英伟达所强调的某些特定智能体推理情景里,执行效能和花费效益的增长幅度远远胜过了仅仅增加内存容量所能带来的好处。靠着对模型参数和缓存的压缩处理、把非活跃的历史记录打包存到成本更低的储存区块、同时改进GPU、处理器和通讯网络间的资料分发管理,整套系统就能从数量相当的存储资源中榨出更多富有意义的运算成果。
英伟达指出,对于AI运算中心的经营者来讲,核心指标并不在于拥有多少个处理器单元或多少量的高速存储,而在于在确保用户交互反应时间的约束条件下,在有限电力配置范围内能输出多少有价值的字符单位。单位瓦特力能生成更多字符单位,这就代表着同一份电力供给能支撑更多任务完成、创造更高营收,并且摊低单个字符单位的获取代价。