选举结束翌日上午,OpenAI 管理团队召集会议。根据知情人士的信息,会议中心议题是 2027 年数据中心容量目标是否需要调整。虽未有定论,但业界的紧张情绪已明显浮现。
数个月来,全美范围内大型数据中心项目纷纷陷入停滞。德州前州长 Abbott 自 8 月起对数据中心的并网及环保许可施以冻结,称要审计至年末;新州长 Gina Hinojosa 则放话,待州议会完成居民保护立法前暂时禁止新项目获批,而立法期限延至 2027 年 5 月。
俄亥俄州新州长 Amy Acton 附加条件地暂停:新建项目必须自行承担电力开支,仅限旧工业区建设;佐治亚州新州长 Keisha Lance Bottoms 拟签署行政命令,全州停建。
根据 Tokenpost 的统计,从今年 7 月至 11 月初,至少 21 个大型数据中心项目遭到取消,这个数字已然接近 2025 年全年的 23 个。Anthropic 在其 10 月 26 日的招股说明书中也将这一威胁列为风险:多个地区的暂停令既有批准也在酝酿,足以延缓甚至阻断公司所需的算力基础设施;且反对声浪正跨越行政边界,组织化程度不断提升。
倘若将现实趋势延伸到极限,假设美国所有筹划中的数据中心最终难产,这对 AI 的现状与前景将产生何种影响?
01 五成的算力机遇殒落
为清晰划定推演范畴,我们构建这样的极端场景,基于以下三项前提:
1、全国范围内所有未启动的规划项目悉数冻结,这相当于把现行约 41% 的限制政策全面推广;
2、在建项目如期竣工,与德州等州对新审批的既有限制一致;
3、芯片供应正常,仅电力和地皮构成硬性约束。分析局限于美国境内,暂不涉及算力向海外转移的情形。
此情景中,被困的算力体量达到何种规模?据 Newmark,美国目前数据中心电耗约 60GW(这是全行业的数字,不仅限于 AI 领域)。而在建的容量各机构说法各异:Cleanview 报 57GW、Wood Mackenzie 报 80GW、DCMap 8 月统计为 90GW。这些项目在假设中照例竣工,将成为美国未来数年算力扩张的唯一来源。
问题在于尚未启动的规划项目规模之巨,DCMap 8 月数据为 228GW,Wood Mackenzie 披露的管线总额超过 430GW,取 230-340GW 作为较为稳健的估值。
由此粗估,极端情景中,美国数据中心总量将在 2028 年上下锁定于 120-150GW 左右,为现状的 2-2.5 倍,随后停止攀升。相比 Synergy 预言的 2029 年翻倍目标,以及若管线项目全部实现本应达到的 5 倍规模,极端情景付诸的代价是那倍增之后的庞大增量。
换成芯片数量更易想象。1GW 电力约可驱动数十万块 Blackwell 级芯片:按单颗满功率 1.8-2.3kW,约 43-55 万块;实际园区如 Abilene,单 GW 约 27 万块。230-340GW 规划搁置,等同数千万块顶级 AI 芯片无处投用。
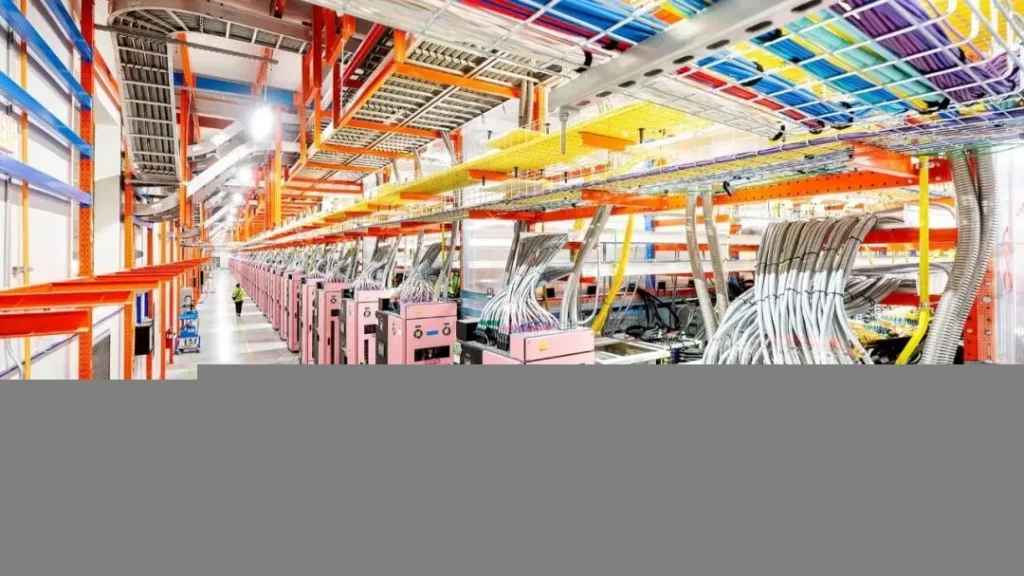
亚马逊为 Anthropic 建设的 Project Rainier 园区内部|图片来源:Amazon
这个极端情景虽然夸张,但并非无稽之谈。据 Cleanview,新州长们承诺暂停的州的规划容量累计达 158.6GW,占比全国 41%(德州 88.4GW、俄亥俄 21.9GW、佐治亚 20.2GW、新墨西哥 11GW、纽约 9.9GW)。换言之,情景中接近半数的冻结已获得政策层面的真实承诺。2024 迄今被取消的 69 个大型项目中,33 个的罪魁祸首是本地反对声浪。参议员桑德斯甚至提出全国性暂停提案,尽管获批概率甚微。
需要坦率指出的是,当前规划数据含水量不少。德州电网 ERCOT 的排队容量达 474GW、涉及约 1800 个项目,这是该电网峰值负荷的 5 倍左右,多数属于占位性质的投机申报。因此,极端场景的实际算力削减幅度小于账面显示。纵使剔除泡沫,仍属一次算力增长的急转。
02 现在无虞,后代遭厄
倘若极端情景明日降临,普通用户在一两年内察觉不出差异。2027 年前的前沿模型继续照常进行训练与升级。
因为现有模型所倚靠的训练基础设施早已竣工或近在咫尺。根据 Epoch AI 数据库,现有规模最大的 AI 园区是 Anthropic 与亚马逊合作的印第安纳州 New Carlisle 园区(1037MW),排名第二的是 xAI 的 Colossus 2(946MW)。OpenAI 在德州 Abilene 的园区总规划 1.2GW,8 个楼座中的 6 个截至 9 月已交付,年底有望完全就绪。
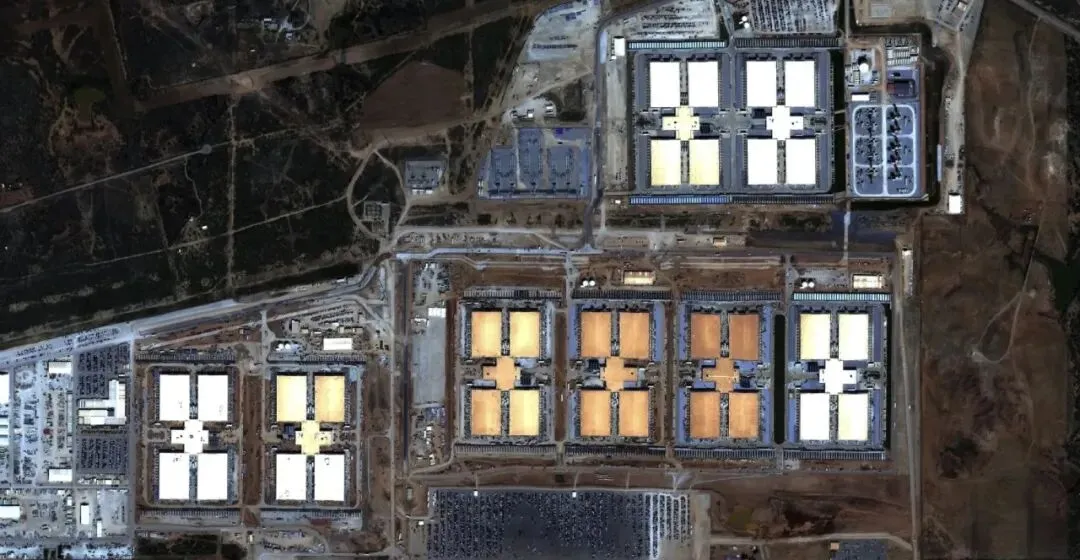
OpenAI 位于德州 Abilene 的 Stargate 园区卫星图|图片来源:Epoch AI
受困的是筹划在 2028-2030 年亮相、需消耗数个 GW 算力才得以培养的新一代模型。
Epoch AI 数据透露,前沿训练电力需求年均增幅为 2.2-2.9 倍,当下前沿训练已逾 100MW。Epoch 展望未来 12 个月,多数园区将跨越 1GW 阈值,两年后最大训练规模或达约 250 万块 H100 等效单位;按此进度,2030 年的单笔最大训练电耗将在 4-16GW 之间。
对照之下,眼下最大园区刚踏过 1GW 门槛。Epoch 指出,数据中心容量即训练规模的天花板:园区规模定死,模型规模上限也就随之确定。
而面向 2028 年后的宏大项目已多有碰壁。
OpenAI 的 Stargate 宏划目标 2029 年破 9GW,美国 7 处站点中的大多数原计划 2027-2028 年大规模启用,主要分布在暂停州份德州、新墨西哥及俄亥俄。
其中 Abilene 周边的扩建计划已告吹;新墨西哥州 Doña Ana 的 Project Jupiter(规划 2.45GW)在今年 3 月遭州土地办公室否决其供气管道方案;俄亥俄州 Lordstown 站点至 4 月卫星影像仍未显现大规模建设迹象。
Meta 的 Prometheus 园区(约 1GW)同样坐落俄亥俄,唯有路易斯安那州志在 5GW 的 Hyperion 项目幸免此轮暂停。
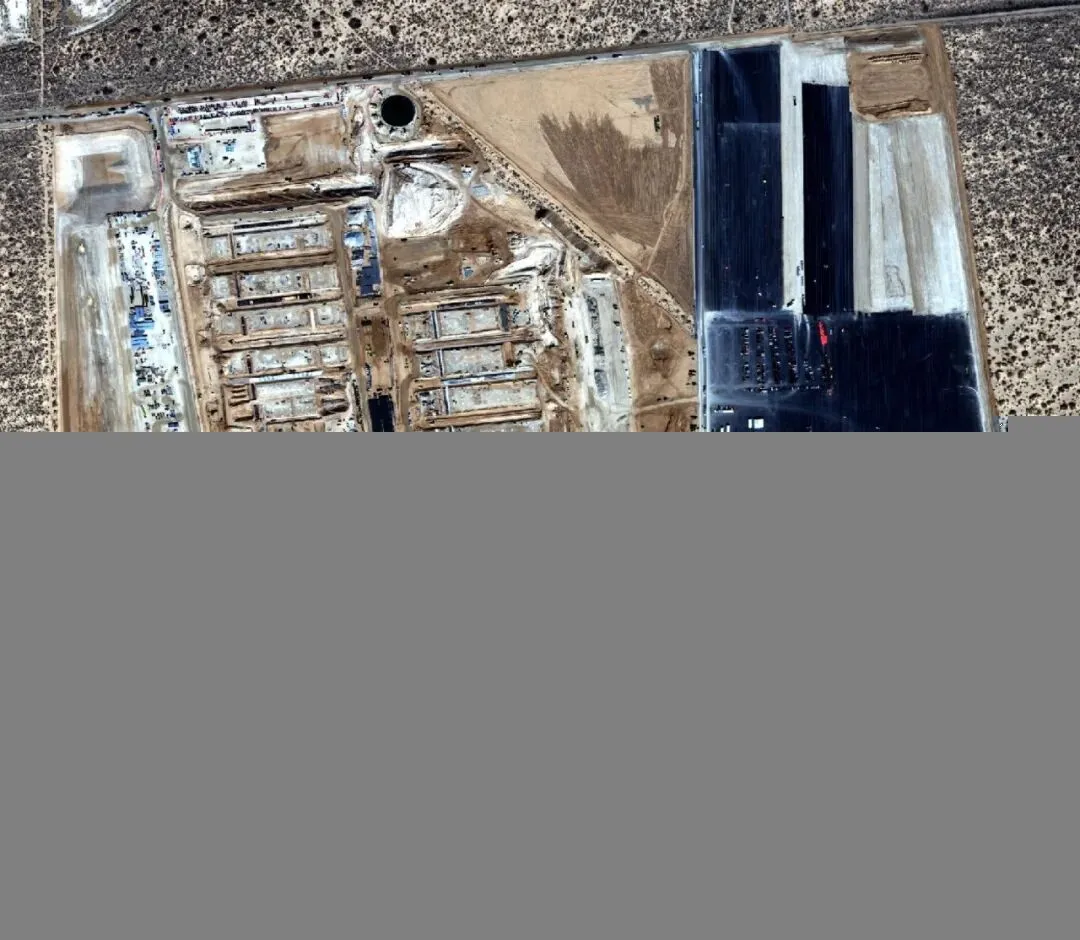
新墨西哥州 Doña Ana 的 Project Jupiter 工地卫星图|图片来源:Epoch AI
由此引出下个问题:下一代训练基地暂停后,AI 进步的节奏会被拉长多少?
03 放缓而非停顿
回应这个疑问,需将算力增长的成分分解审视。
Epoch AI 统计显示,自 2020 以来前沿语言模型的训练算力年均增幅为 4-5 倍,同期耗电增幅仅 2.2-2.9 倍。中间约 2 倍的差距源于芯片能效革进,单位电力递送的算力在递增。
除硬件外,算法亦在出力。通常认定算法效能每年升 3 倍(Ho 等 2024 研究给出约 2.7 倍)。Epoch 将后训练纳入后估约每年 10 倍,但范围从 2 倍至 50 倍宽泛不一,本文采纳更为稳健的 3 倍数字。
现在可进行粗步推演。
常态下,AI 年度「有效算力」扩增等于物理算力增长(4-5 倍)乘算法进阶(约 3 倍),约年均 12-15 倍。
情景 A 中,2028 年后电力新增停滞,物理算力增长的最大支撑被拔除,仅余芯片迭代所来的能效跃升(约每年 2 倍)。再乘以算法的 3 倍,「有效算力」年增速从 12-15 倍跌至约 6 倍。
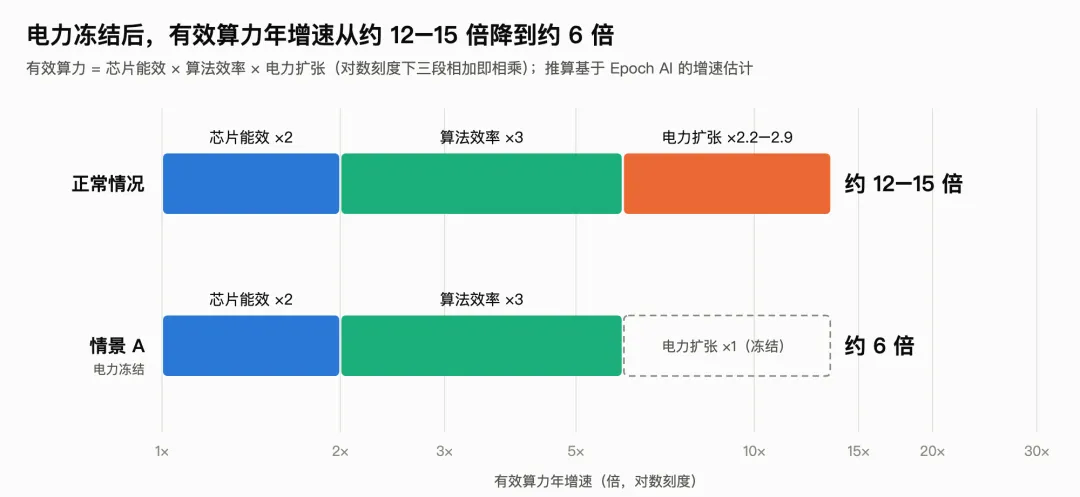
有效算力年增速拆解:正常情况与极端情景 A 对比(推算)|图片来源:极客公园
若采用 Epoch 较为乐观的算法假设(每年约 10 倍),常态有效算力增速为每年 40-50 倍,情景 A 约 20 倍。两类口径均表明,电力冻结致使有效算力增速陷落至原有水平的四分之一至一半。算法突进再猛,也无法填补电力扩容留下的空缺。
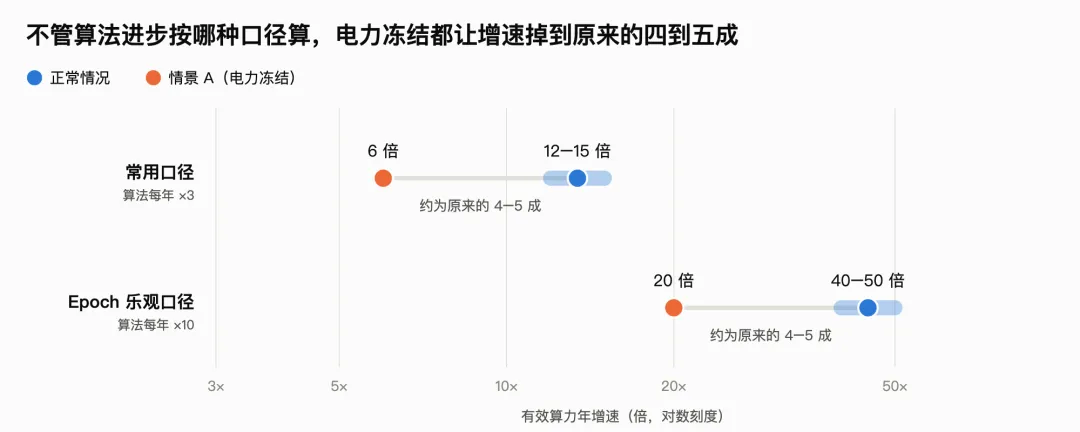
两种算法口径下,电力冻结前后的有效算力年增速(推算)|图片来源:极客公园
另有隐患存焉。芯片能效的收益以新芯片顺利入驻机房为前提。机房总电量既定后,电源与冷却改造的复杂度可能削弱这 2 倍的效能。
纵使如此,每年约 6 倍仍属可喜数字。综合推演,结论昭然若揭:
极端情景中,AI 虽将明显减速,但不至停顿。
然而这笔账仅涵盖训练所需算力部分。若纵览整体 AI 运作,电量既定后,另一场争夺将随即展开。
04 Token 定量年代序幕
以往电力短缺就新圈地新建机房。在极端情景中,总电量既定,每分配给训练的电力都必须从推理、智能体及后训练中挪挪腾。
市场算力早已倾向推理。据德勤预测,推理在全部 AI 算力中的占比:2023 年约三分之一,2025 年约二分之一,2026 年预计逼近三分之二。
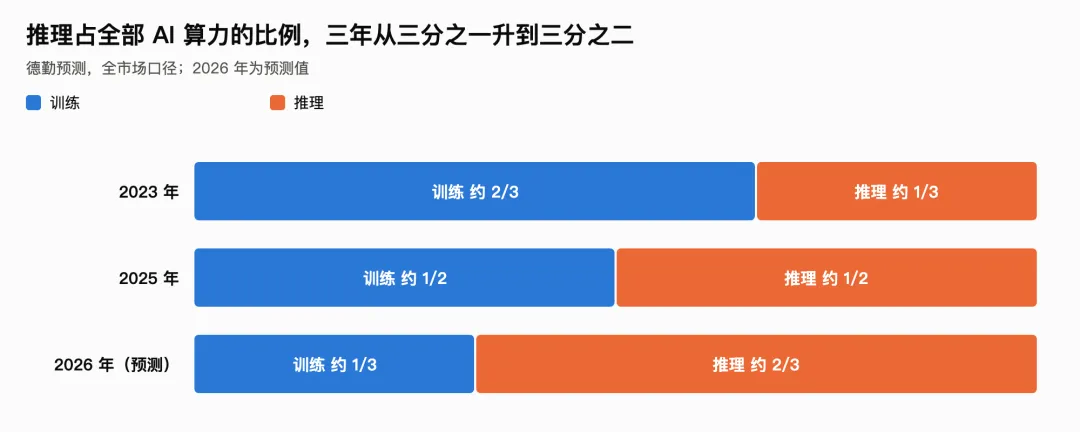
推理与训练在全部 AI 算力中的占比变化|图片来源:极客公园
AI 实验室内部亦在调整。根据 SemiAnalysis 基于 OpenAI 与 Anthropic 合并算力的估测,2024 年初预训练占 67%、后训练及强化学习约占 5%、推理约 29%;其后预训练占比逐季递降,二季度 63%、三季度 57%、2025 年跌至五成余,后训练占比一路上升,最新测算两者已势均力敌。研究人士提醒,这是比例变动,实验室总算力翻增多轮,预训练绝对值可能未减。
更大的压力源于产品样态。推理模型答题前会生成冗长思维链,虽用户不见,但每步都耗能量。据 Gartner,智能体执行一项任务的 token 消耗为常规对话的 5-30 倍。
高盛预言,2026-2030 年全球 token 累计消耗增幅将达 24 倍。
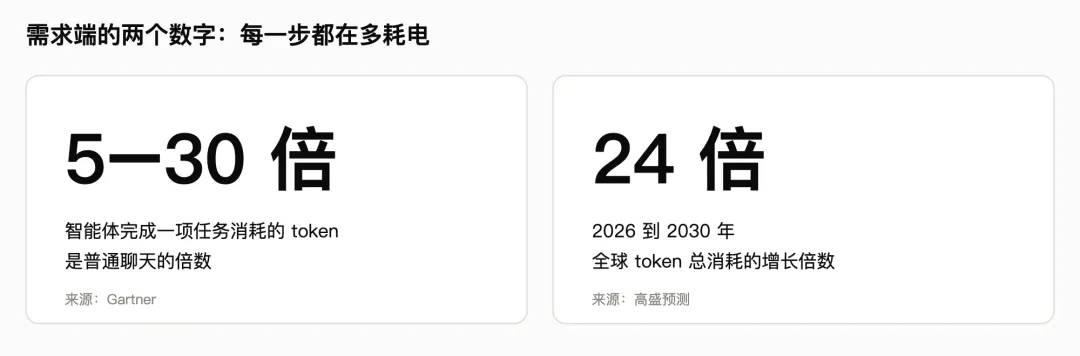
智能体与 token 消耗的增长|图片来源:极客公园
将这些数据代入极端情景的恒定电量,各家实验室都将面临同一道二择题:每一兆瓦既可用于下一代超大模型训练,亦可供当下用户与智能体调用。
若欲调配数十万块芯片训练更巨大的基座模型,就须限制既有用户的使用额度;若优先保障推理与用户体验,下一代模型的进展则面临延宕。
电力扩容这条路既已被堵,剩余的课题便是:在电量和算力固定的约束下,AI 如何继续前进?
05 四条突破口
在极端情景的压力之下,那些曾因「大可增卡」而被冷落的省电技术将成为主流选项:
第一,将硬件评估指标转向「每瓦电输出多少 token」。
在电力既定的机房内,以新高效芯片替旧芯片是唯一的扩容途径。
英伟达如今首选的指标即「全口径电力单位兆瓦每秒输出 token」,其分母囊括园区全部电耗,包括冷却与网络。这指标走红本身就表明,芯片厂商心知肚明客户瓶颈在电,芯片数量倒属次要。
按英伟达说法,Vera Rubin 单位瓦能效是 Blackwell 的 10 倍,智能体场景下与 GB300 对标最高可达 30 倍。独立检测亦证实了相近结论:CoreWeave 实测在等同 DeepSeek R1 负载、相同响应速度的条件下,Vera Rubin NVL72 单兆瓦 token 产出为 GB200 NVL72 的 10 倍。惟 Rubin 迟至下半年才启动量产,广泛应用需等到 2027 年。
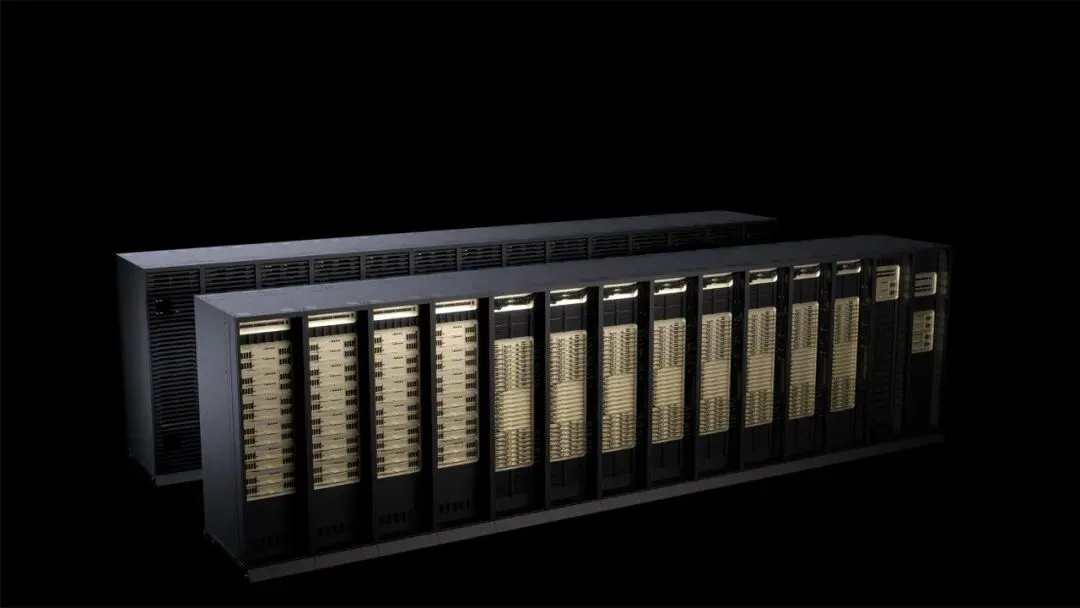
英伟达 Vera Rubin NVL72 机柜|图片来源:NVIDIA
第二,跨园区分布式训练。
暂停令的矛头多指动辄百兆瓦级的大型中心。自然的规避之策是将训练任务分拆,配置于各地中小机房。策略压力会直接催生分布式训练的技术需求。
这条路大厂们已在探索。谷歌曾说明 Gemini 在多处集群上同步训练;微软串联了威斯康星与佐治亚机房;CoreWeave 与谷歌云推出了跨云训练。谷歌的 DiLoCo 研究显示,普通网络连接就可实现远程设施间的训练,并能容纳硬件故障。
但这条路充满挑战。DiLoCo 作者亦坦言,该技术目前仅可补充超大集群,无法成为替代品。2026 年仿真研究发现,机房间隔数十至数百公里时,网络延滞会显著弱化计算与通信的重叠,许多算力空耗于数据等待。
第三,将研发重点从预训练转向后训练与强化学习。
预训练对单一超大集群的依赖度最高,极端情景下首当其冲。数个 GW 级集群难以筹建,工程团队会转向对规模要求相对较低的后训练、强化学习以及混合专家架构、低精度计算等改进。Cursor 曾言其 Composer 1.5 模型的后训练算力投入已超预训练。
第四,边缘侧与小模型为云端减负。
至 2026 年,蒸馏已成小模型的主流路径。量化后的小模型可在手机 NPU 上直接处理结构化业务,十亿参数以下模型约每秒可运行 12-15 个 token。越来越多应用采纳混合策略:小模型优先在本地处理绝大多数请求,仅将少数复杂需求递送云端大模型。
06 束缚中的生机
极端情景锁定的是美国本地电力。对另两类参与者,这种约束反而开启了机遇:在效率路线沉淀多年的模型企业,以及欲入局的 AI 创办人。
先看前沿与追赶者的间隙。Epoch AI 今年 5 月的测算表明,顶级开源模型相比闭源前沿平均滞后约 4 个月,大致相当于 GPT-5 与 GPT-5.5 之间的水平落差。往日前沿实验室通过每年十几倍的有效算力增幅不断扩大领先;极端情景中这一速度退落至约 6 倍,新代差的建立更显艰难,追赶者所需追逐的差距将大为缩小。
再观效率路线的先驱。DeepSeek、Qwen、Kimi、GLM、MiniMax 等中式模型企业向来以开源、轻成本及混合专家框架标榜,这一策略已在使用统计中显露。
根据 OpenRouter 与 a16z 联合研究,中国开源模型在该平台的 token 占比从 2024 年末约 1.2% 攀升至 2025 年逾 29%;步入 2026 年,多项统计数据显示占比在五至六成。
a16z 合伙人 Martin Casado 估计,采用开源技术栈的创业企业约八成运行中国模型。OpenRouter 仅是一个平台,未含 ChatGPT 流量与企业私有部署,然而趋势已明朗:
当整个产业都需应答「每度电能生成多少智能」这一大题,长期钻研此问题的团队,其积累的经验将更具价值。
来源:极客公园